快速起手式 可再自行修改
角色對嘴
電影長鏡頭
歷史紀錄
清空
生成來源 按需顯示,不堆按鈕
✦ 純文字
▣ 關鍵幀
◎ 全能參考
↗ 舊動作
▶ 接續
Turbo 4步只支援純文字;切到Turbo 8步或標準25/20步即可使用圖片/影片來源。
首幀 第 0 秒 ×
未選
上傳 貼上
末幀 最後一格 ×
未選
上傳 貼上
+圖片(0–9)
貼上參考圖
影片(0–3 支,總長≤15秒)
尚未選擇
+影片(每支2–15秒)
舊人物圖片
尚未選擇
上傳人物圖
音訊(0–3 段,總長≤15秒)
尚未選擇
+音訊(每段2–15秒)
純文字生成 純文字
模型會依下方文字自行建立第一格。
選擇要接在哪支完整影片後面
完整影片接續
固定鎖住來源最後一幀作為新段第 0 幀,同時把尾端連續 2–5 秒送入 H3,保留步態、速度與運鏡。
到影片庫預覽後再選
這些圖代表什麼?
同一主體的不同角度
每張是不同主體
同一主體時,所有圖片卡請填相同 @名稱。
清除目前圖片/接續
導演稿 可直接描述,或按標籤細分
畫面
主體
場景
動作
鏡頭
台詞
聲音
音樂
風格
限制
可直接寫一段繁中構想;DeepSeek 會依片長整理成 AI 可生成的故事節拍,每段都有可見事件、主動作、鏡頭與終點狀態。非台詞會在本機轉成英文 IR;中文台詞完全不翻譯。
✨ DeepSeek 思考擴寫
逐段安排可見事件+動作+鏡頭+終點;結果先預覽
DeepSeek 擴寫預覽
套用這版
還原原稿
取消
輸出設定 16GB 顯卡安全範圍
輸出秒數 2 秒 3 秒 4 秒 5 秒 6 秒 7 秒 8 秒 9 秒 10 秒 11 秒 12 秒 13 秒 14 秒 15 秒
方向 橫式 16:9 直式 9:16
生成步數 Turbo 平衡|8步 Turbo 預覽|4步 標準品質|25步 標準回退|20步
畫質/解析度|預估生成時間 標準 416×736|Turbo估時待實測 高畫質 448×800|Turbo估時待實測 原生滿解析(實驗開放)
LoRA 套件 原版 H3|全部關閉 女性通用包|HMPussy+HMNSFW 女性 Innie 完整包|HMPussy+HMInnie+HMNSFW 女性 Synth 實驗包|Synth Pussy+HMNSFW 男性通用包|HMPenis+HMNSFW Pink Fluffy Bunny|社群 LoRA 0.5 After Midnight v1.2|Ref2VA 專用
原版預設全部關閉。女性通用影片自動掛 vagassist 1.0、hmpussy 0.35、HMNSFW 0.35;Innie 完整包另加 HMInnie 0.4;Synth 實驗包掛 Synth 0.8、HMNSFW 0.35;男性通用包掛 HMPenis 0.8、HMNSFW 0.35;Pink Fluffy Bunny 圖片/影片皆掛 v2 rank128 0.5;After Midnight v1.2只在Ref2VA+標準25/20步可用,自動改用Euler+beta。
標準25步:新預設;估時採20步實測乘1.25粗估,排隊時間另計。20步仍可回退。
已套用固定資源 profile;解析度/幀數包絡源自本機20步實測,實際步數依上方選擇。
已驗證profile仍保留;另把原生滿解析改為實驗開放:各種來源皆可選,2–15秒直式768×1344、2–5秒橫式1344×768,每種秒數參考素材都最多12檔,並可搭配該來源原本相容的25/20/Turbo 8步。只有6–15秒橫式與Turbo 4素材模式保留結構限制。未逐一實測的組合可能OOM、很慢或高溫;5秒25步實測約44分36秒、峰值15,753MiB VRAM與88°C。
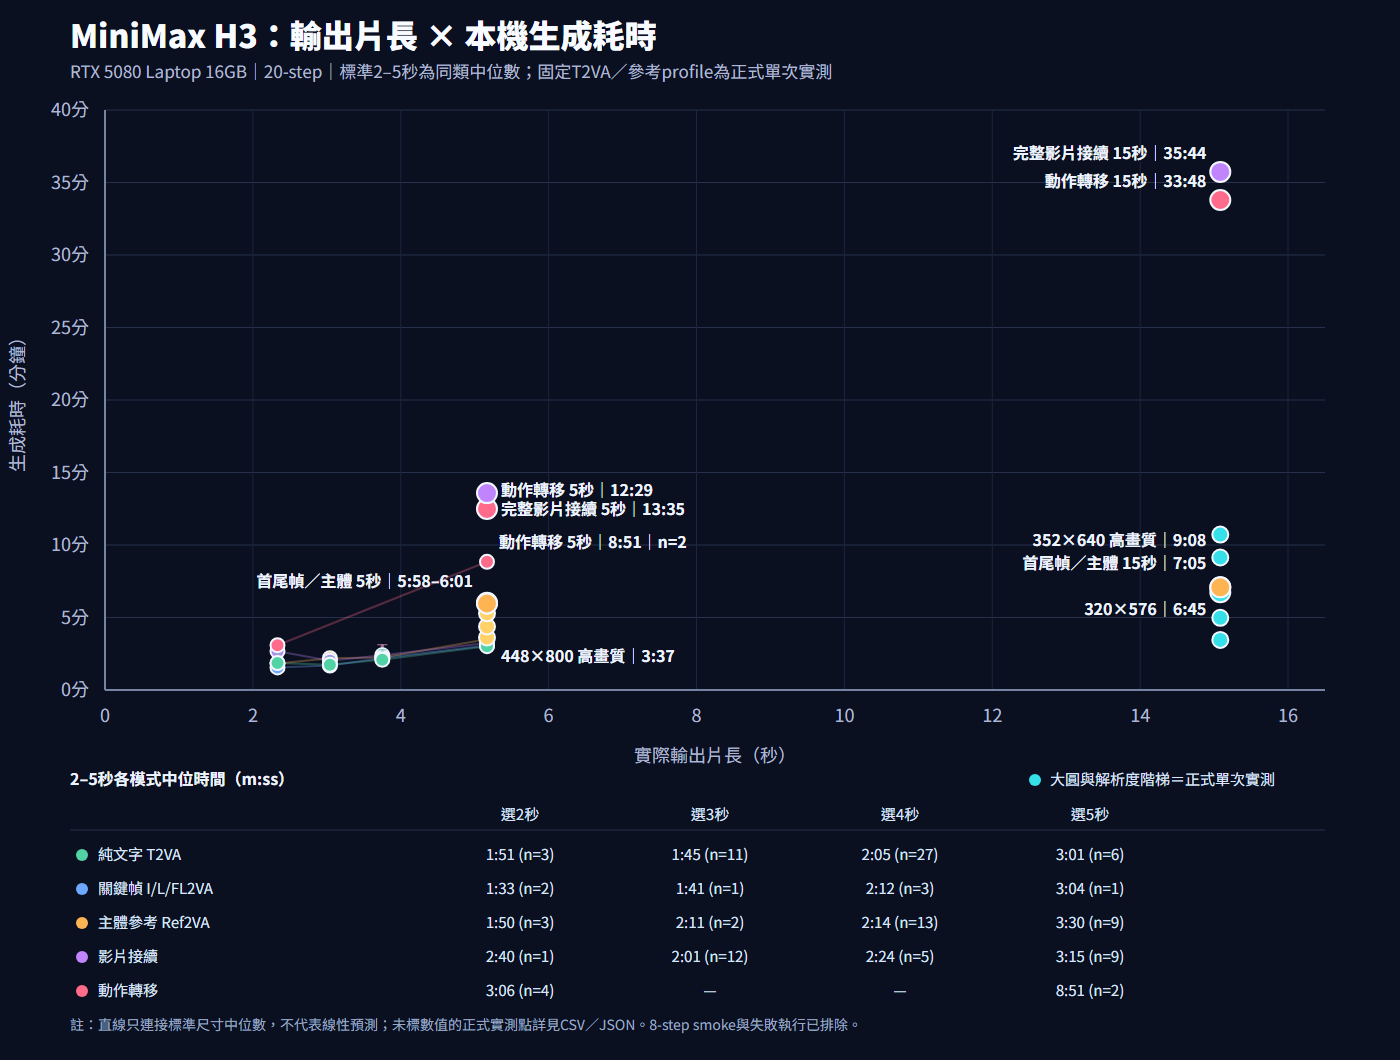
實測耗時圖:輸出片長 × 生成時間
點一下圖表即可開啟高清PNG,再縮放查看各資料點。
彙整114次標準尺寸2–5秒紀錄,另標出4個T2VA 5秒解析度、5個T2VA 15秒解析度,以及8個已成功的固定參考profile實測點。6–14秒由相同工作流的15秒最高包絡向下開放,沒有偽裝成獨立實測點;8-step資源測試未混入實用品質圖。
進階設定
送出後會進入本機佇列;完成影片直接回到 Telegram。
抽一張角色卡 預設 Female+NSFW+成年
🎴 抽卡
退出角色
抽中後只保存角色,不會自動呼叫AI,也不會建立圖片或影片工作。
靈感模型 創作與互動故事共用
選擇這次使用的模型
DeepSeek V4 Flash|雲端
Huihui Qwen3.8 27B|本機無審查
DeepSeek速度較快;Qwen首次使用需約20秒載入,之後在本機生成。
✨ 創作靈感
💬 互動故事
這次先做哪一種? 所選模型只產生你選的草稿
這次想要的方向(可留空)
影片片長 5 秒|單一主要動作 10 秒 15 秒
🖼️ 幫她想一張圖
🎬 幫她想一支影片
只做草稿預覽;最後仍由你到圖片或影片頁按生成。
單幅故事 同一瞬間、同一畫面
重想圖片 送到圖片頁調整
AI 互動故事 清空故事
角色會依卡片人格與目前場景自然回覆;ina 預設為男性第一人稱主角,不另行發明年齡。換卡或退出角色會清空這段故事。
讓角色開始第一幕
你要說什麼或做什麼?
送出並繼續故事
🖼️ 把目前場景做成圖片草稿
🎬 把目前場景做成影片草稿
故事保存在你的 Mini App 狀態;不會自行生成媒體。
本機 Qwen 沙箱 Huihui Qwen3.8-27B 無審查版
狀態
Huihui Qwen3.8-27B Q4_K 未載入
16GB特調:部分GPU offload、mmproj留CPU、Q4 KV、單slot、65K context。
載入模型 停止/卸載 清空會話
沙箱只保存你的會話與你上傳的圖片;模型沒有shell、主機檔案、外部網路或任意工具權限。H3開始生成前會自動卸載Qwen,避免16GB VRAM互撞。
對話模式 官方Qwen3.8採樣值
移除 尚未對話。第一次送出會載入模型,約需20–60秒。
訊息
送給本機 Qwen
不使用OpenAI/DeepSeek額度。生成中可按「停止/卸載」直接終止本機模型。
1 選擇原片5秒・24fps・124幀
本人已完成的H3影片
正在讀取… 只處理已完成且能對上原始生成報告的單人H3影片。修臉版會建立成另一支影片,原片不會被覆蓋。
先分析是否值得修
2 適用性預檢CPU分析・不啟動H3
低於30px・生成細節 30–60px・最實用 高於60px・改善有限
這不是銳化濾鏡:FaceRefine會用H3重新生成局部臉部再貼回。低於30px的五官不是原身份細節的真實復原。
確認並開始修臉
4 原片/修後比較同步時間軸
原片
修後
兩者
放大臉
以正常觀看尺寸判斷是否真的更好;「放大臉」只供細節檢查,不代表全畫面差異同樣明顯。
重新選片 下載修臉版
修臉紀錄 原片與修後版都保留
Music3 音樂生成 本機 INT8・歌聲與純音樂
更新紀錄
音樂描述 中文或英文皆可
描述曲風、速度、調性、樂器、歌聲、編曲與結尾;越具體越容易穩定重現。
歌詞 留空=純音樂
可用 [Intro]、[Verse]、[Pre-Chorus]、[Chorus]、[Bridge]、[Outro] 分段;短秒數請減少歌詞。
ani 幫寫 先預覽,不會自動生成
要幫哪一欄 寫/改音樂風格 寫/改歌詞
告訴 ani 你想怎麼改
✨ ani 幫我寫
正在確認官方 Music3 參考庫與 DeepSeek 設定…
會將目前音樂描述、歌詞與這句需求送往 DeepSeek。風格模式依官方 1000 模板漸進檢索;歌詞模式使用獨立寫作契約。
輸出設定 RTX 5080 Laptop 16GB
音樂與影片共用序列佇列;開始音樂前只會卸載閒置 H3 模型,不會關閉服務。10 秒已實測約 108.5 秒、峰值約 12.8GB VRAM;15/30/60 秒尚未逐一量測,排隊時間另計。
音樂紀錄 完成後可播放/下載
生成模型 切換時只顯示適用設定
選擇模型
Anima 2.9B|動漫/美感 SenseNova U1.5|寫實/文字/多風格 Anima 使用正/負提示與品質檔;SenseNova 使用自然語言、官方4MP畫布與50 steps。
SenseNova 提示法 官方+社群實例濃縮 簡單畫面: 主體 → 動作 → 場景 → 構圖/鏡位 → 光線 → 媒材風格。少量限制直接用自然語言最穩。
複雜畫面: 依序寫「畫布、主體、空間位置、次要元素、文字原文、材質光影、must keep、should avoid」。要出現的字用引號包住;不需要文字就明寫「不要添加任何文字」。
範例: A full-body editorial portrait of a woman with a high ponytail, centered on a rain-soaked rooftop; low-angle camera, neon reflections, realistic wet skin, detailed hands, cinematic photography. No logos, captions or extra people.
圖片描述 英文自然語句/標籤最穩
請寫主體、服裝、姿勢、場景、構圖、鏡頭與光線;中文也可嘗試,但 Preview v1 以英文描述或標籤較穩。
✨ DeepSeek 擴寫 Anima
正在確認完整 2.9B 規則與 DeepSeek 設定…
Anima 擴寫預覽
Positive prompt
Negative prompt
套用這版
還原原稿
取消
輸出設定 單張 PNG・RTX 5080 Laptop 16GB
圖片尺寸 1/4|448×576 1/2|640×832(預設) 1x|896×1152 God|1088×1408
品質 標準|30 steps・CFG 4 細節|36 steps・CFG 4.5
SenseNova 官方畫布 直式|1760×2368 橫式|2368×1760 方形|2048×2048
Seed(留空隨機)
1/2 是 Anima 預設:標準品質實測 35.8 秒、峰值 8.81GB VRAM、62°C。模型與其他生成共用序列佇列。
圖片生成紀錄 完成後可預覽/下載
編輯模型 切換時保留H3草稿
選擇模型
H3|多圖/素材/LoRA SenseNova U1.5|單圖自然語言編輯 SenseNova 目前只開放已驗證的單圖編輯;額外參考圖、素材生成與LoRA仍交給H3。
SenseNova 編輯提示法 變更+保留邊界 第一句只寫要改什麼。 接著列出必須保留的身份、臉、姿勢、構圖、背景、光線與鏡位;最後補材質、物理接觸、遮擋與陰影。不要只寫「更好看」。
範例: Change the jacket to cobalt blue. Preserve the same face, hairstyle, pose, body proportions, background, lighting and framing. Change no other clothing or objects.
🪄 圖片編輯
🧩 素材生成
🎨 文字生成
LoRA 套件 依圖片模式自動套用
選擇套件
原版 H3|全部關閉 女性通用包|vagassist 女性 Innie 完整包|vagassist+HMInnie 女性 Synth 實驗包|Synth Pussy 男性通用包|HMPenis Pink Fluffy Bunny|社群 LoRA 0.5 圖片只列出單張T=1相容套件:vagassist 1.0、HMInnie 0.4、Synth 0.8、HMPenis 0.8、Pink Fluffy Bunny 0.5。原版預設全部關閉;After Midnight 是Ref2VA影片專用,所以不會列在這裡。每筆紀錄會保存實際檔名、hash與強度。
1. 選原圖 PNG/JPEG/WebP・≤12MiB
▣ 點一下選擇原圖 保留原始解析度,不套影片素材縮圖
尚未選擇。
從相簿選擇 貼上原圖
更換原圖 原圖放入素材板 移除
1. 選素材 0/9 張
到素材板選圖
沒有原圖錨點;1~9張圖片都是平行素材,依加入順序標成 @素材1~@素材9。到素材板按「加入素材生成」,再用標籤指定各圖只負責人物、服裝、物件、姿勢、風格、場景或構圖。未指定的內容不應自動混入,但H3仍可能產生聯想。
2. 額外參考圖(實驗/選填) 0/8 張
從相簿多選 貼上參考圖
原圖固定是編輯主體;額外圖依加入順序標成 @參考圖1~@參考圖8。請點標籤插入修改指令,明確說要借用它的服裝、人物、物件、姿勢、風格或地點。模型邊界:整張他人照片可能連身份、姿勢與道具一起帶入;只借服裝/物件時,先裁成不含臉與背景的局部圖通常較穩,但仍可能生成聯想物件。
3. 修改指令 只描述要改什麼
修改內容
指令送法
DeepSeek 忠實翻譯|繁中→英文(預設)
原文直送|不呼叫 DeepSeek
送出後先由 DeepSeek 只翻譯、不擴寫;@參考圖標籤與「引號內文字」會原樣保留,翻譯失敗不會排入GPU。
H3會重新生成整張圖,不是像素級遮罩修補;未指定的主體、構圖、光線與細節會盡量保留,但不保證逐像素相同。
4. 輸出設定 依原圖比例・32倍數
精確模型會在第一次生成時啟動;與影片、音樂及Anima共用GPU序列佇列。
等待中 排隊中
只顯示ComfyUI真實step;模型載入與VAE解碼不偽造百分比。
編輯結果 原圖不會被覆蓋
以結果再編輯 結果放入素材板 複製結果圖 下載PNG
圖片編輯紀錄 點一筆載入設定/結果